Funciones
Todo el ciclo de vida de tus modelos locales, en una sola aplicación.
Inventario Inteligente
Detección automática de modelos GGUF/GGML/safetensors con metadatos GGUF, variantes embebidas (MTP, visión), agrupación por carpeta y etiquetas.
Despliegue Automático
Lanza modelos con templates de hardware, toggles de flags con ayuda oficial, estimador de VRAM, decoding especulativo MTP, presets de sampling, logs en vivo y runtime llama.cpp embebido con descarga verificada.
Interacción Fluida
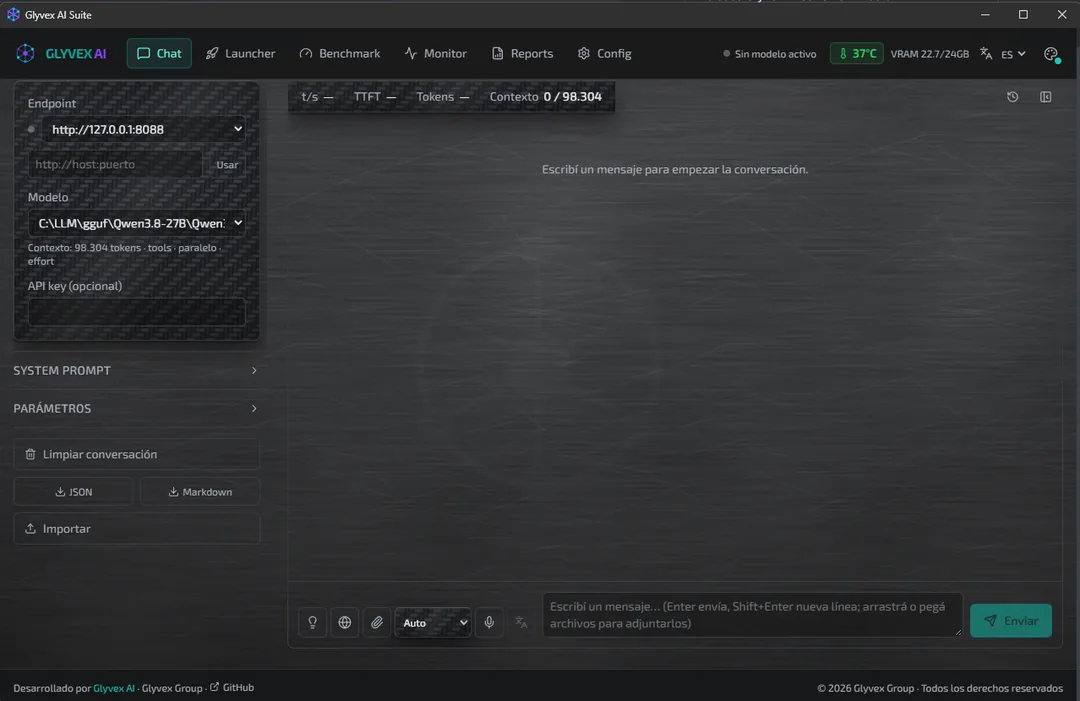
Chat con streaming token a token, panel de razonamiento, métricas en vivo (t/s, TTFT), adjuntos, voz a texto, historial con ramas y tool calling nativo.
Evaluación Automática
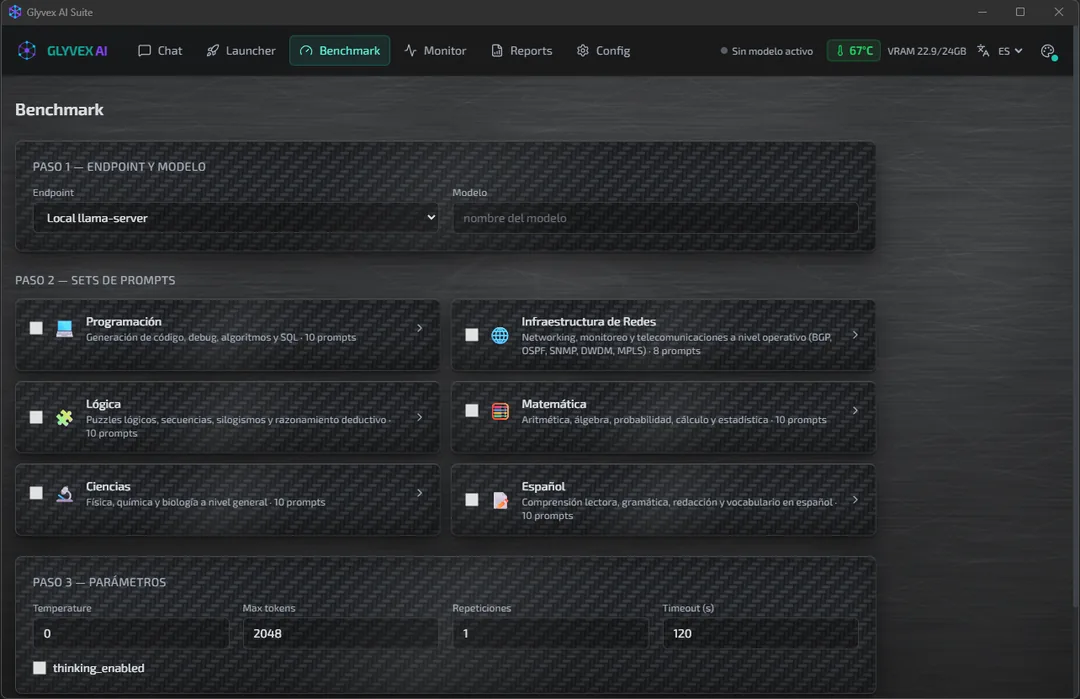
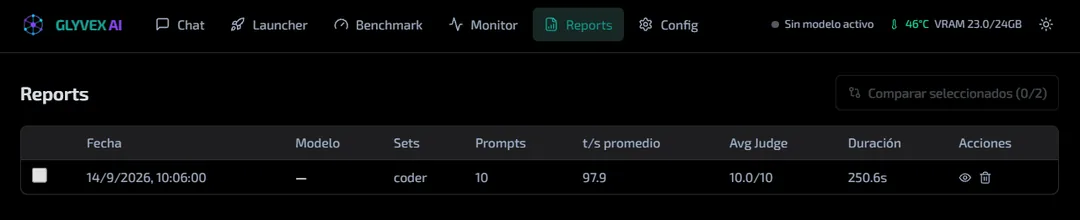
Suite de 58 prompts en 6 categorías, sets propios, scoring por keywords o judge LLM, historial de runs y reportes HTML autónomos.
Tu máquina, en vivo
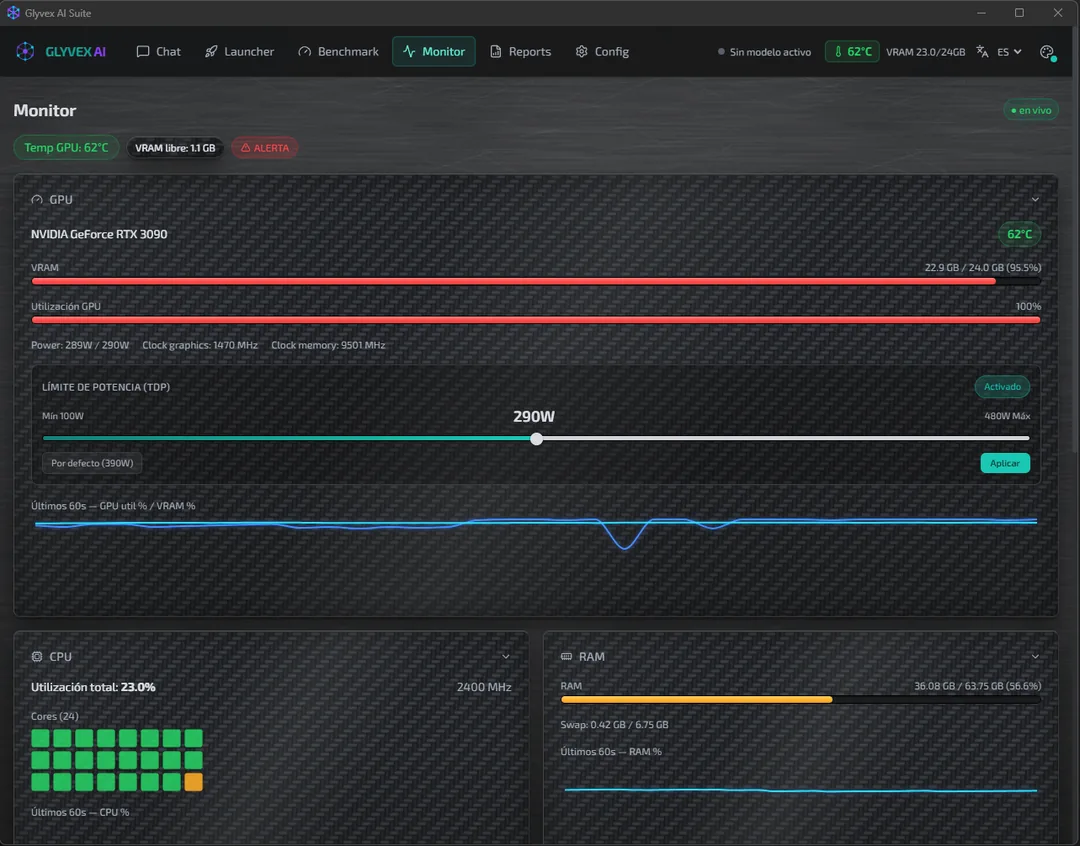
GPU (utilización, VRAM, temperatura), CPU por core con heatmap y RAM, vitales del LLM server (t/s, contexto, cola, caché) e histórico persistente con retención configurable.
Agentes con contexto
Búsqueda web local (SearXNG, Brave, Tavily, DuckDuckGo) y fetch de URLs con bloqueo de hosts privados por defecto.
Capturas
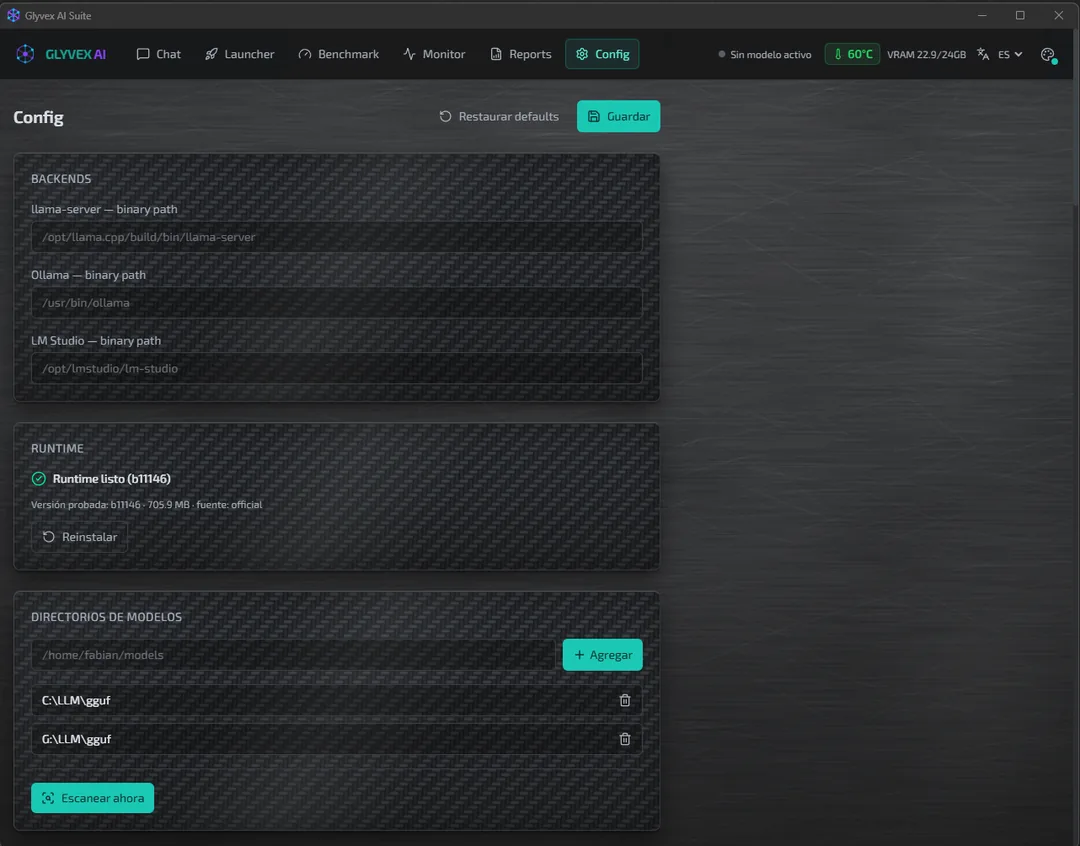
La suite en acción: cada vista, corriendo en tu máquina.
Módulos
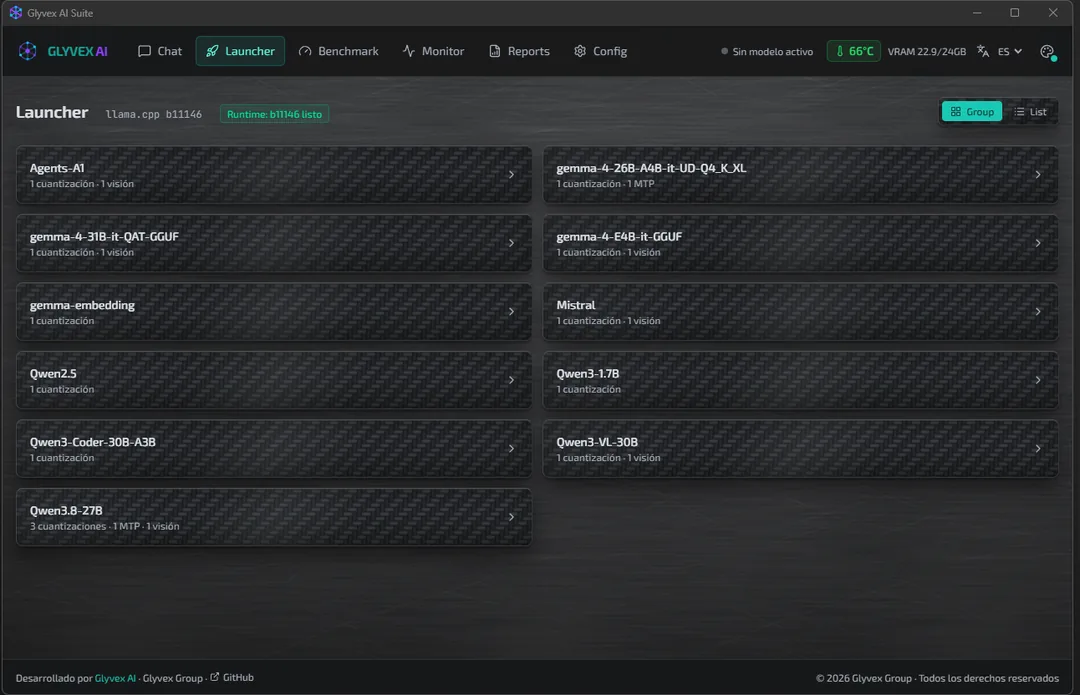
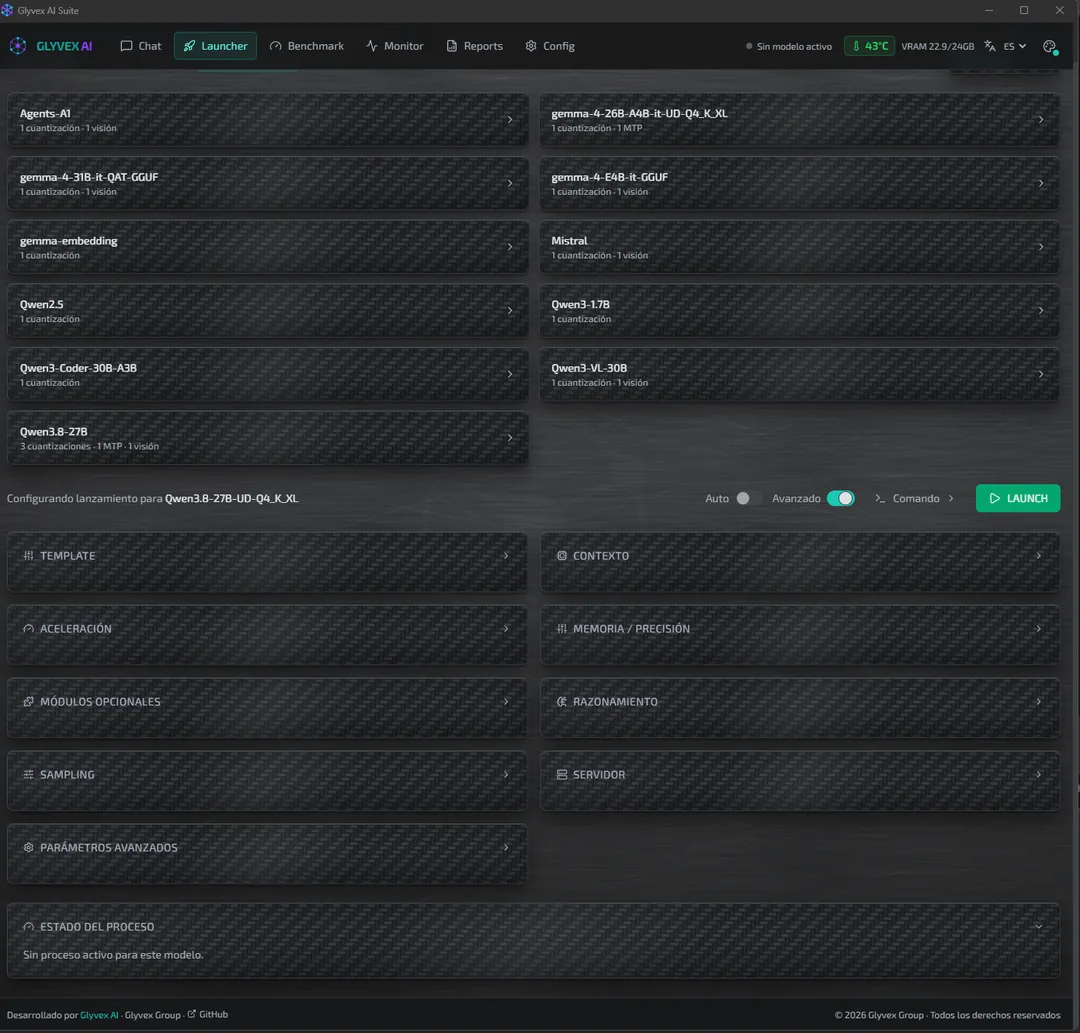
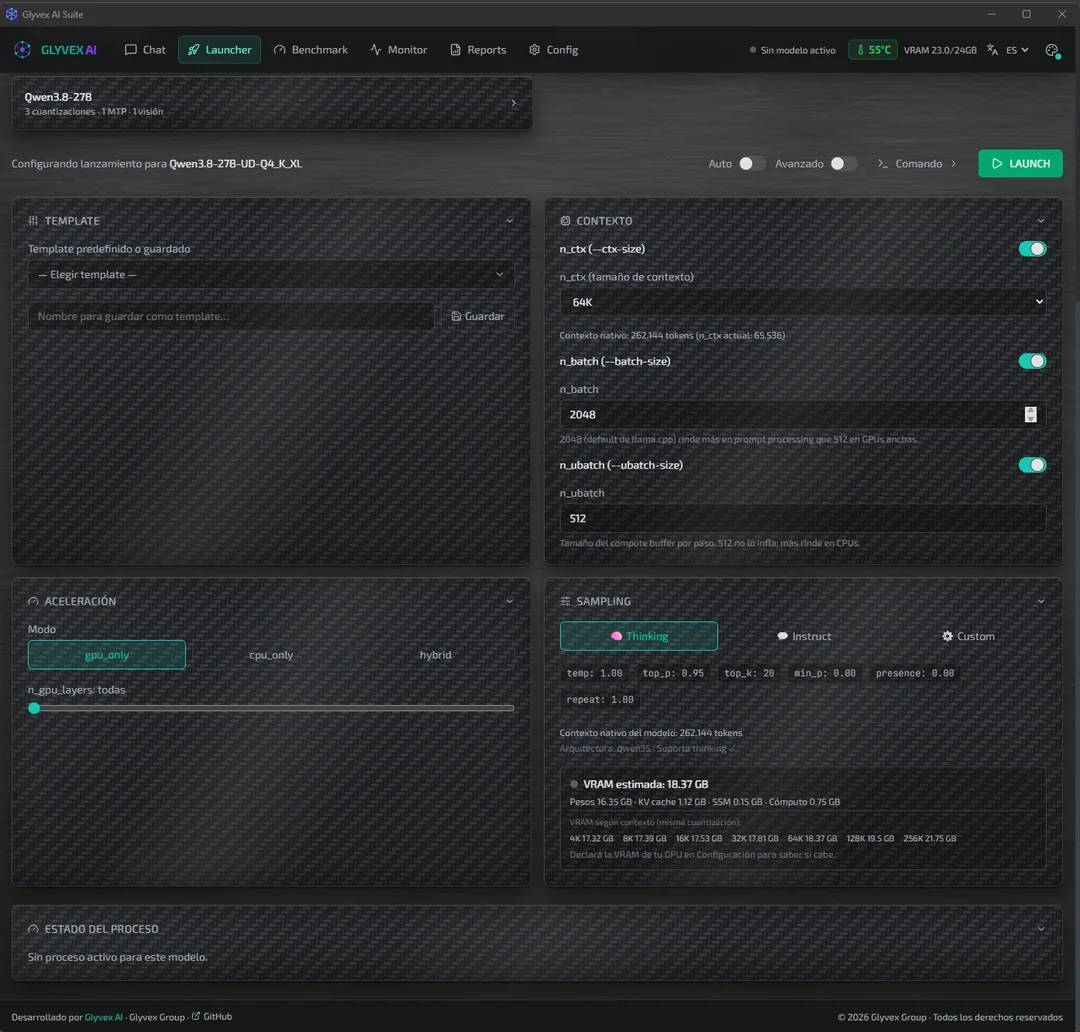
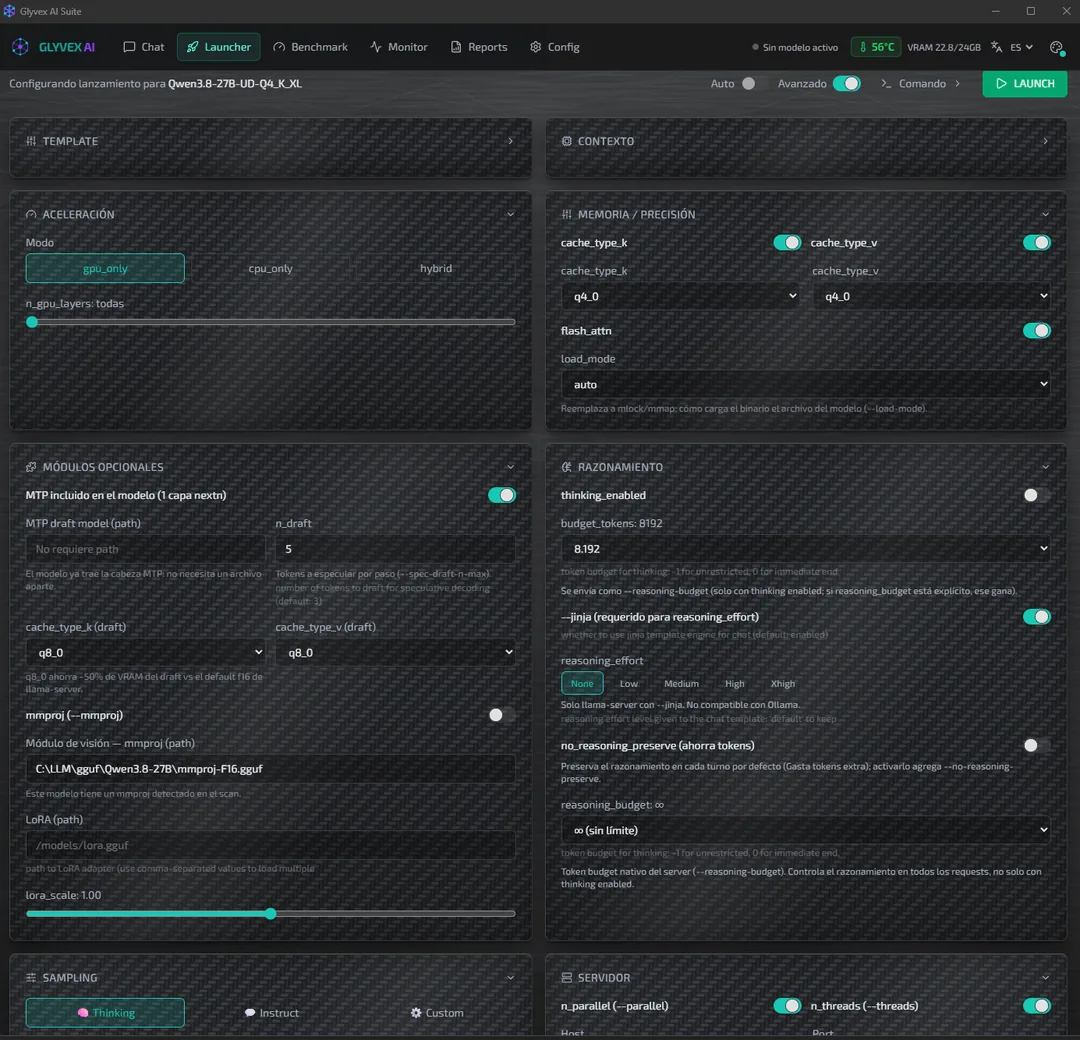
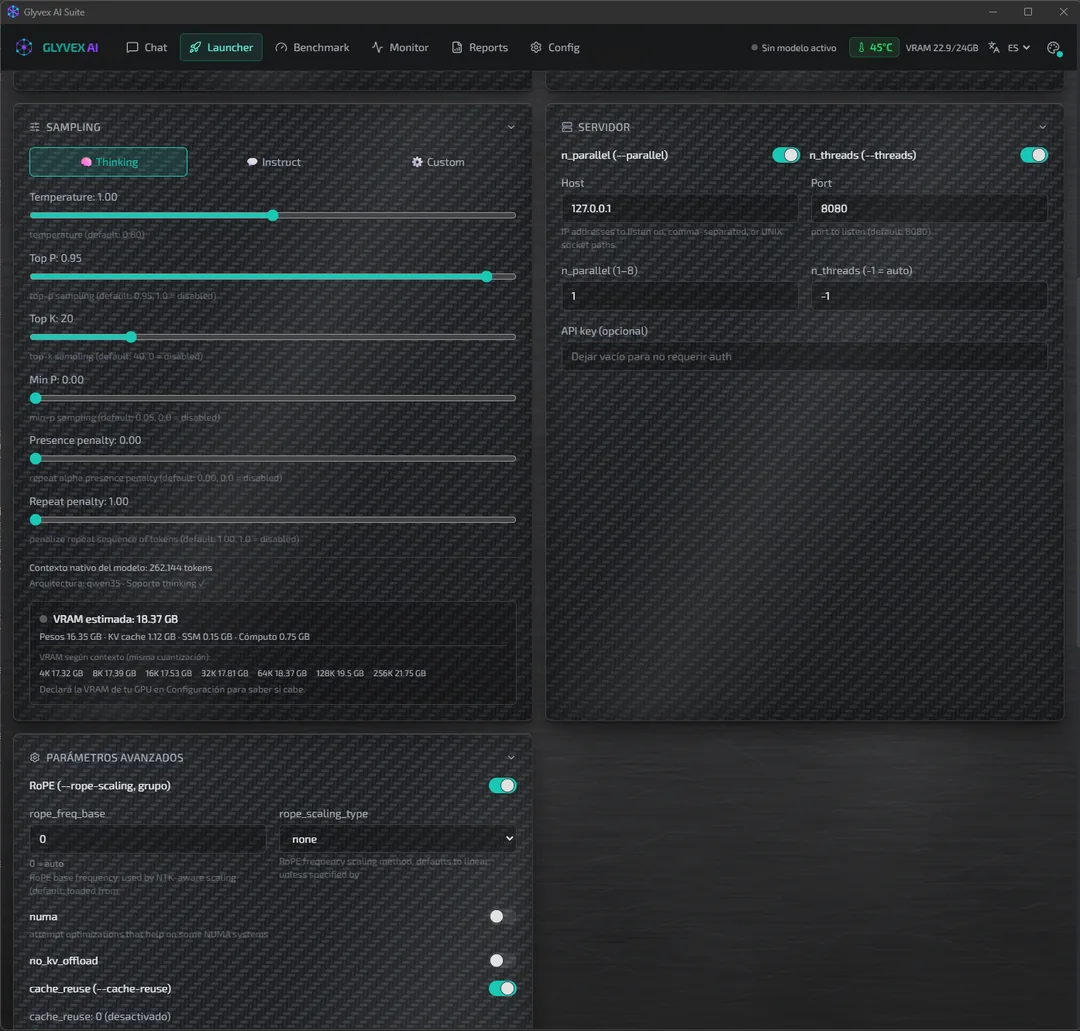
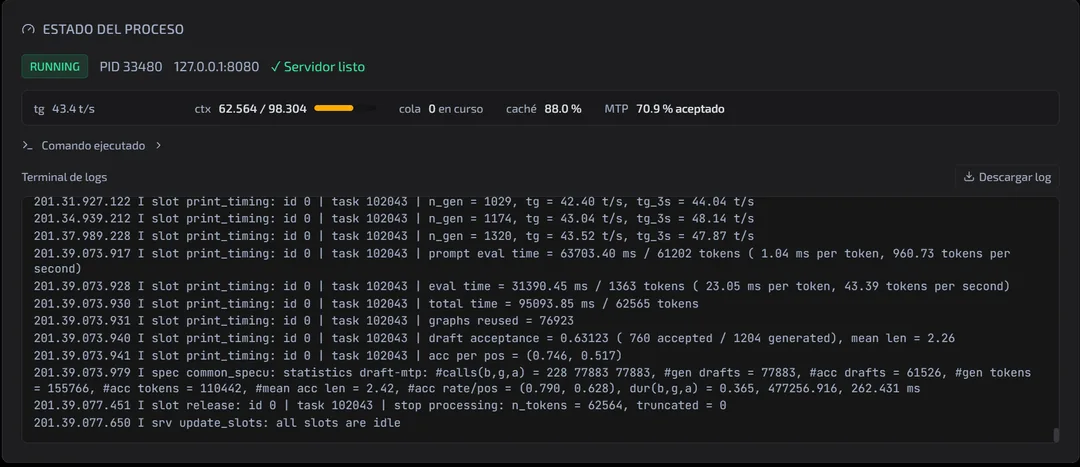
Launcher — control fino
Lanzar un modelo es un panel, no una terminal: contexto, aceleración, VRAM estimada, MTP, visión, LoRA y servidor.
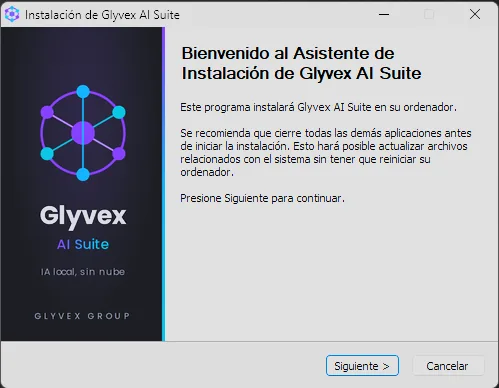
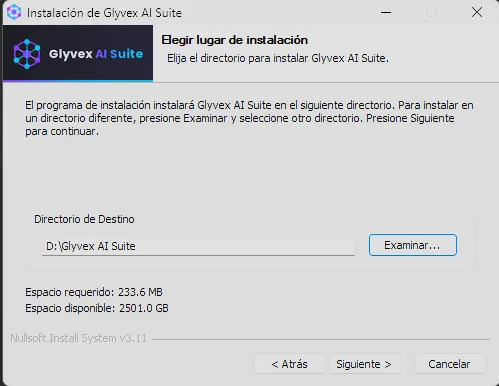
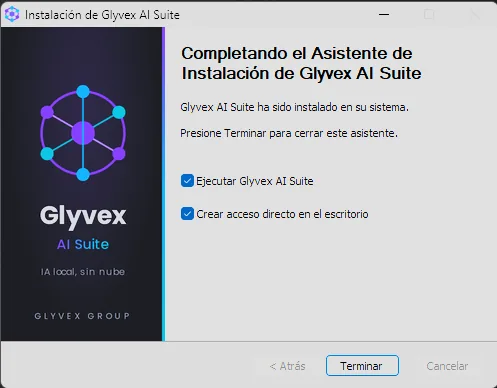
Instalación en 3 pasos
Un instalador clásico de Windows: elegís la carpeta y listo.
Cómo Funciona
Desde la configuración hasta el chat, en cuatro pasos.
Configura
Indica dónde está tu backend (llama.cpp, Ollama o LM Studio) y tus carpetas de modelos.
Escanea
La suite detecta automáticamente tus modelos, metadatos y variantes, con progreso en vivo.
Lanza
Elige un modelo y ejecútalo con un clic, con logs en tiempo real y health checks.
Chatea y evalúa
Interactúa en tiempo real y compara tu modelo con la suite de 58 benchmarks.
Para empresas
El núcleo es open source y gratuito. Para desplegarlo en una organización, sumamos servicios y módulos con licencia comercial.
Núcleo open source
Para personas y equipos que quieren correr modelos locales hoy mismo.
- Todas las funciones de esta página
- Runtime llama.cpp embebido, verificado por sha256
- Código auditable en GitHub, con análisis CodeQL en cada cambio
- Uso comercial permitido por la licencia
- Soporte de la comunidad en GitHub Issues
Edición empresarial
Para organizaciones que necesitan desplegar con garantías y en redes cerradas.
- Instalación y puesta en marcha en tu infraestructura, incluso en redes sin internet
- Runtimes de llama.cpp validados por arquitectura de modelo antes de cada actualización
- Paquetes de actualización offline con checksum SHA256
- Soporte directo y prioritario
- Módulos empresariales: multiusuario, inicio de sesión corporativo (SSO) y auditoría — en desarrollo
- Sin telemetría
- Descargas verificadas por sha256
- Análisis de seguridad CodeQL
- Política de privacidad
Requisitos
La suite corre donde corras tus modelos.
Backend de inferencia
Necesitas uno de estos motores en tu máquina —o, en Windows, dejar que la suite descargue su runtime embebido de llama.cpp— además de Python 3.11+ (runtime del backend) y Node.js 20+ (compila el frontend la primera vez):
- llama.cpp (llama-server)
- Ollama
- LM Studio
- Runtime embebido (Windows)
Modelos
Cualquier modelo en los formatos estándar de la comunidad:
- GGUF
- GGML
- safetensors
Sistema operativo
El estado de cada plataforma sigue el roadmap del proyecto:
- Windows (desarrollo y pruebas)
- Linux (próximamente)
- macOS (próximamente)
Hardware
Funciona en cualquier máquina; para rendimiento alto se recomienda:
- GPU NVIDIA (monitoreo VRAM/temperatura)
- RAM suficiente para el modelo elegido
Preguntas Frecuentes
¿Necesito conexión a internet?
No. La suite y los modelos corren 100% en local. Solo necesitas internet para las herramientas opcionales de búsqueda web o para descargar el runtime embebido, y siempre porque tú lo pides.
¿Es gratis?
El núcleo sí: es open source bajo licencia Apache-2.0. Lo descargas, lo usas —también con fines comerciales— y nada sale de tu máquina. Para organizaciones ofrecemos además servicios y módulos con licencia comercial (ver Para empresas).
¿Qué licencia tiene?
El núcleo se distribuye bajo Apache-2.0: puedes usarlo, modificarlo y redistribuirlo, también con fines comerciales, conservando los avisos de licencia. La marca Glyvex y su logo no forman parte de esa licencia. Los módulos de la edición empresarial tienen su propia licencia comercial.
¿Qué backends soporta?
llama.cpp (llama-server), Ollama y LM Studio. En Windows la suite puede descargar su propio runtime de llama.cpp verificado, sin instalación aparte. El launcher gestiona el ciclo de vida de cada proceso: arranque, logs en vivo, health checks y parada con escalado SIGTERM→SIGKILL.
¿Dónde se guardan mis datos?
Todo queda en el disco de tu máquina: SQLite para conversaciones y benchmarks, JSON para inventario y configuración, y carpetas locales para adjuntos y reportes. No existe nube.
¿Puedo crear mis propios benchmarks?
Sí. Además de la suite de 58 prompts, puedes crear y administrar sets propios de prompts para evaluar exactamente lo que te importa.
¿En qué idiomas está la interfaz?
Español e inglés. Cambias el idioma desde el selector de la app y se recuerda entre sesiones.
Changelog
- Detección de hardware y recomendaciones: Config muestra un panel de hardware auto-detectado y el Launcher sugiere configuraciones con escalera adaptativa de ventana de contexto; nueva card de carga del modelo con deltas reales de RAM/VRAM (bloques MEDIDO y ESTIMADO) y estimación de VRAM para Sliding Window Attention, MTP especulativo y caché GPU de expertos MoE
- Monitor: alerta de fuga creciente de VRAM sostenida en el tiempo; Chat: adjuntos .pcap legibles como resumen de texto; logs completos con rotación y retención configurables, con botones "Abrir / Exportar log completo"
- Primer minor completo publicado como estable: las instalaciones 0.11.x lo reciben como update interno. Nueva distribución ZIP green sin instalador para Windows (portable, con README bilingüe) y docs con registro de modelos verificados en inglés y español
- Chat: la búsqueda del historial ahora coincide contra un índice de texto plano (título + texto de los mensajes) en lugar del JSON crudo: desaparecen las falsas coincidencias con palabras comunes y los bloques de razonamiento también son buscables; las bases existentes se migran y rellenan solas al arrancar
- Monitor: el ahorro estimado frente a pagar un servicio cloud equivalente ahora se destaca con una tarjeta verde y un chip compacto en el header de los paneles de consumo
- Docs: README en inglés con capturas de la app en inglés, dashboard de ejemplo de Grafana agnóstico del bucket (elige el bucket con un dropdown), reporte de seguridad y changelog de temas bilingües
- Soporte AMD de punta a punta: la suite detecta la GPU AMD y ofrece los runtimes oficiales de llama.cpp con Vulkan y ROCm, validado en hardware real a ~99 tokens/s sostenidos; el Monitor ahora también muestra temperatura, utilización, VRAM y ventilador en GPUs AMD
- Métricas de largo plazo: totales de consumo de por vida y por servidor en el Monitor, exportación a InfluxDB y Prometheus, y una nueva guía con un dashboard de ejemplo para Grafana; Benchmark: juzga corridas guardadas desde Reports y prueba cualquier endpoint OpenAI-compatible
- Puente de agentes con OpenCode: los servidores que lanzas aparecen como agentes listos para usar en tu configuración de OpenCode; runtime embebido actualizado a llama.cpp b11827; precios de nube base ampliados a 36 proveedores
- Monitor: panel de Costo de sesión con seguimiento de tokens por sesión y comparativa contra precios de nube (configurables en Ajustes)
- Temas externos: carga tus propios temas desde una carpeta sin reinstalar ni reiniciar (la app los autodetecta y aparecen en el selector); Benchmark: selección de prompts individuales para comparar modelos solo en los que te interesan
- Flujo de actualización del runtime pulido; panel de parámetros avanzados reorganizado en grupos colapsables que recuerdan qué tenías abierto; fix de caché post-actualización en el arranque (sin recargas manuales)
- Actualizaciones dentro de la app: la interfaz nueva aterriza sin recargar a mano (los recursos web se sirven con cabeceras de caché correctas y la app detecta si sigue cacheado un bundle de la instalación anterior, recarga una sola vez en lugar de esperar un F5 manual)
- La barra de progreso de la descarga de la actualización nunca se queda trabada: si el servidor no informa el tamaño anima un estado indeterminado; Monitor: el panel de curvas de ventilador GPU carga aunque el backend siga arrancando justo después de una actualización (prueba con reintentos acotados)
- La aplicación instalada usa de verdad las fuentes incluidas: Glyvex Sans, JetBrains Mono y Poppins las sirve el backend embebido con el tipo de contenido correcto (antes el webview las descartaba)
- Monitor: curvas de ventilador personalizadas por GPU, con restauración automática del estado previo al cerrar o actualizar la app; nueva bandeja del sistema en Windows (minimizar a bandeja y salir)
- Plantillas de contexto 128K para equipos con DIMM dual; el sampling por defecto se lee automáticamente de los metadatos GGUF de cada modelo; caché KV q8_0 por defecto en llama.cpp; Benchmark con selector de modelo unificado y filtros texto/visión
- Correcciones: decodificación especulativa MTP con modelos draft y LoRA resuelta en todas las plantillas; chips de imagen del selector de modelo; selects nativos, bandeja y sidecar embebido en Linux; nueva fuente Glyvex Sans v2.010
- Actualizador: la barra de progreso de la descarga ahora refleja el avance real (callback DownloadEvent del plugin de actualización corregido)
- Monitor: un watchdog del WebSocket de métricas descarta conexiones zombie/silenciosas tras el relanzamiento de una actualización en app — el control de ventilador y las métricas GPU vuelven sin recargar (F5)
- Linux x86_64: nueva build AppImage firmada, validada en Ubuntu 22.04+, con backend sidecar embebido; auto-actualización multiplataforma vía latest.json en formato platforms
- Runtime: soporte Linux x64 (bundle nativo) y bundle CUDA elegido según la arquitectura de tu GPU (Pascal y más nuevas cargan cada una su build correcta)
- Monitor: multi-GPU — una card por GPU con TDP y alertas por índice, lectura de ventilador con control 0-100% y verificación por lectura (visible también en navbar y barra de alertas)
- Seguridad: extracción de zip contenida, locks async en descargas TTS, manejo de errores endurecido en Chat/Monitor/Launcher/Benchmark/Reports y health polling que degrada en cargas lentas en vez de fallar
- Modelos: el escaneo de directorios usa los model dirs actuales del panel, sin necesidad de guardar la config antes · Chat: lista de modelos vía proxy del backend y parada ordenada de llama-server
- Monitor: gráficos acumulativos de tasa de aceptación MTP y de caché · Launcher: offload de expertos MoE a CPU (--n-cpu-moe, filtrado por build) y diálogos nativos para elegir binarios y archivos (con entrada manual en navegador)
- Auto-update: corregido el upgrade in-place (el instalador ya no instala al lado de la versión anterior) y recuperación de chunks obsoletos tras una actualización (recarga única y segura)
- Nueva tipografía de marca: Glyvex Sans (variable, 100-900) reemplaza a Exo 2 en toda la app — tipografía 100% autoalojada, sin peticiones a fuentes externas
- Auto-update: la URL de descarga (latest.json) ahora usa el nombre real del asset en GitHub — las actualizaciones se resuelven y descargan correctamente
- Auto-update: el canal de actualización ahora apunta al repositorio público oficial — las instalaciones de la release pública pueden encontrar e instalar las actualizaciones correctamente
- Versión consistente: los archivos de la app (frontend, backend e instalador) ya no reportan versiones distintas entre sí
- Instalador: ahora muestra el selector de idioma español/inglés y los accesos directos se instalan en la carpeta Glyvex-AI-Suite del Menú Inicio
- Auto-update: el updater ya no deja el backend viejo corriendo durante la instalación y aplica los permisos necesarios para reiniciar con la nueva versión
- TTS: la reproducción vuelve al elemento <audio>, corrigiendo el audio mudo en algunos entornos Chrome/Edge/WebView2; un fallo de reproducción se muestra ahora como aviso, no como silencio
- TTS: cache de WAV en el backend (LRU 32): re-escuchar la misma respuesta es instantáneo y no resintetiza
- Config: la detección de Web Search / STT / TTS ya no tarda 30-45 s (caché TTL 60 s por firma de config) · Chat: los últimos 5 endpoints personalizados se persisten en el selector
- Temas nuevos en la app: carbon, metallic y matrix —con lluvia digital que se pausa en segundo plano y respeta la opción de reducir movimiento— y un tema claro renovado en tono lavanda
- Runtime embebido actualizado a llama.cpp b11146, la build oficial de ggml-org, verificada por sha256
- Mejoras en exportación de métricas, streaming y estimador de VRAM · requisito de Python 3.11+ declarado en el proyecto
Entérate de cada novedad
Nuevas versiones, runtimes validados, herramientas y funcionalidades. Te escribimos solo cuando hay algo que vale la pena.
¡Empieza hoy mismo!
Descarga Glyvex AI Suite y pon tus modelos a trabajar, sin nube y sin costo.
SHA256 Windows: 04bfc9dc9016f21d6242b7aedec1334ac041e725ba3f8badff4b7be90504e825 · Linux AppImage: 9c240051982238f29c34aed66c122f5532e629b34eaadc1ee659b065d89625cc